Vibe coding en PME : le vrai risque, ce sont vos données
Phrase entendue : « On a vibe codé une application qui fait tout. »
Environ 2 000 applications d'entreprise accessibles depuis n'importe quel navigateur, sans mot de passe. Des données financières, des conversations de patients, des documents stratégiques. Elles n'ont pas été piratées : elles n'ont simplement jamais été fermées.
C'est ce qu'a mis en évidence la société Red Access en mai 2026, en analysant des centaines de milliers d'applications créées avec des outils de vibe coding. Pour une PME, le sujet n'a rien de théorique. Il y a de bonnes chances que l'un de vos collaborateurs ait déjà construit un petit outil de ce type, sur des données de l'entreprise.
Le vibe coding, ou l'application créée en une après-midi
Le principe est simple : on décrit à une IA ce qu'on veut (« un tableau de bord qui suit nos devis en cours », « un formulaire pour les demandes de congés ») et elle génère l'application complète, prête à être mise en ligne. Des plateformes comme Lovable, Replit ou Base44 ont rendu la chose accessible à n'importe qui, sans une ligne de code à écrire.
Pour une PME, c'est une vraie opportunité. Un commercial peut se construire l'outil de suivi qu'on ne lui a jamais financé. Une assistante de direction peut automatiser un reporting qui lui prenait sa matinée du lundi.
Le problème est ailleurs. L'IA a rendu la création d'une application presque gratuite. Elle n'a pas rendu gratuite la responsabilité qui va avec : la sécurité, la protection des données, la maintenance, la justesse des chiffres. Et ces sujets sont précisément ceux que la personne qui « vibe code » ne voit pas.
Ce que disent les chiffres
Trois sources sérieuses permettent de mesurer le problème.
1. Des milliers d'applications ouvertes à tous (Red Access, mai 2026)
En analysant environ 380 000 applications hébergées sur des plateformes de vibe coding, Red Access a identifié environ 5 000 applications à usage professionnel qui exposaient des données sensibles. Environ 2 000 n'avaient aucune authentification, aucun contrôle d'accès, aucun historique des consultations.
La cause relevée par les chercheurs est banale : sur plusieurs plateformes, un nouveau projet est public par défaut, et les créateurs qui ne sont pas développeurs ne savent pas qu'il faut changer ce réglage.
2. Une base de données lisible sans se connecter (faille Lovable, 2025)
Début 2025, le chercheur Matt Palmer a analysé 1 645 applications créées avec Lovable. Dans 170 d'entre elles, soit une sur dix, n'importe qui pouvait lire la base de données : listes d'utilisateurs, paiements, clés d'accès à d'autres services. Il suffisait de la clé publique présente dans la page web. La faille a été classée 9,3 sur 10 en gravité.
La raison : le code généré n'activait pas les règles qui limitent chaque utilisateur à ses propres données. L'application affichait bien un écran de connexion, mais la porte de derrière était ouverte.
3. Un code généré qui ne progresse pas en sécurité (Veracode)
L'éditeur Veracode a soumis 80 tâches de programmation à plus de 100 modèles d'IA. Dans 45 % des cas, le code produit contenait une faille de sécurité connue. Sa mise à jour de mars 2026 montre que ce taux ne s'améliore pas, même avec les modèles récents. Les IA écrivent du code qui fonctionne, pas du code sûr.
Les 5 risques concrets pour une PME
Ces chiffres se traduisent, dans une entreprise de 20 ou 100 personnes, par des situations très concrètes.
1. Un outil ouvert à tout Internet
C'est le cas Red Access. Le tableau de bord commercial créé par un collaborateur est en ligne, à une adresse que personne ne connaît… jusqu'à ce qu'un robot la trouve. Les outils de recherche automatisée parcourent ces plateformes en permanence.
2. Des données copiées n'importe où
Pour alimenter son application, le collaborateur exporte le CRM, le fichier clients ou le tableau des salaires, et le dépose dans une base de données gratuite, hébergée on ne sait où. Il n'y a ni contrat avec l'hébergeur, ni mention dans votre registre RGPD, ni personne pour savoir que ces données sont sorties.
3. Des chiffres faux qui ont l'air justes
L'application fonctionne : elle affiche un tableau propre, des graphiques. Mais personne n'a vérifié le calcul, et son auteur ne sait pas lire le code qui le produit. Une erreur dans un outil soigné inspire plus confiance qu'une erreur dans un fichier Excel bancal. Et chaque nouvelle application ajoute sa propre copie des données, figée au moment de l'export : une version de plus du « bon chiffre » à réconcilier en réunion.
4. Un outil invisible, sans propriétaire
Ces applications sont hébergées chez des prestataires externes. Elles n'apparaissent dans aucun inventaire informatique. Personne ne sait qu'elles existent jusqu'au jour où elles tombent en panne, où leur auteur quitte l'entreprise, ou où l'abonnement gratuit expire. Une équipe peut dépendre d'un outil que personne ne sait réparer.
À cela s'ajoute un risque plus technique : les IA suggèrent parfois des briques logicielles qui n'existent pas. Une étude présentée à la conférence USENIX Security en 2025 a relevé ce problème dans près d'un échantillon de code sur cinq. Des attaquants enregistrent ces noms inventés pour y placer du code malveillant.
5. Une responsabilité qui retombe sur le dirigeant
En cas de fuite de données personnelles, c'est l'entreprise, en tant que responsable de traitement, qui doit répondre : notification à la CNIL sous 72 heures, information des personnes concernées si le risque est élevé, sanctions possibles. Le fait qu'un salarié ait créé l'outil de sa propre initiative ne la décharge pas. Le Contrôleur européen de la protection des données l'a rappelé en juin 2026 à propos des outils d'IA non autorisés.
Le vrai sujet : l'accès aux données
Face à ces risques, la tentation est d'interdire. C'est rarement efficace : les collaborateurs qui gagnent deux heures par semaine avec un outil qu'ils ont construit continueront à s'en servir, simplement sans le dire.
Regardez les cinq risques ci-dessus. Presque tous ont la même origine : des données brutes, complètes et sensibles, confiées à un outil que personne n'a validé. Si le fichier exporté ne contenait que les informations utiles, sans noms ni données personnelles, une application mal fermée poserait un problème bien moins grave.
Plutôt que de se demander si ses équipes ont le droit d'utiliser l'IA, un dirigeant gagne à poser une autre question : « sur quelles données, et qui l'a décidé ? »
6 règles simples à mettre en place dès maintenant
Pas besoin d'une direction informatique pour reprendre la main. Voici un point de départ réaliste pour une PME.
- Faites l'inventaire, sans chercher de coupable. Demandez à vos équipes quels outils elles ont créés ou utilisent avec l'IA. Promettez qu'il n'y aura pas de sanction : vous voulez savoir, pas punir.
- Fermez par défaut. Toute application qui touche des données de l'entreprise doit exiger une connexion. Vérifiez le réglage de visibilité de chaque projet sur les plateformes utilisées.
- Ne confiez jamais un export brut. Avant de donner des données à un outil ou à une IA, retirez tout ce qui n'est pas nécessaire : colonnes inutiles, noms, coordonnées, données de salariés.
- Désignez un propriétaire pour chaque outil. Une personne responsable de le maintenir, de le fermer si besoin, et de répondre si quelque chose se passe mal.
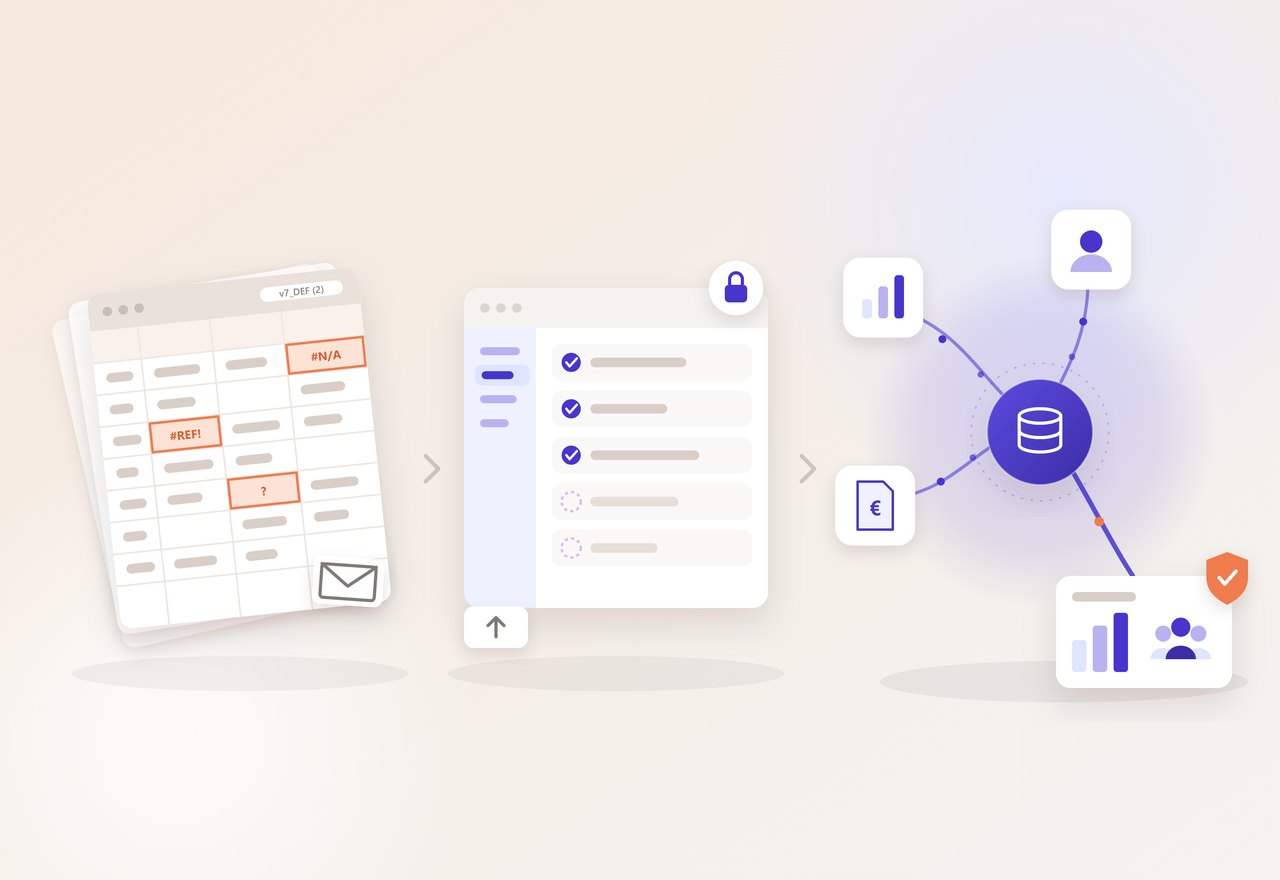
- Gardez une seule source de vérité. Plutôt que de multiplier les copies figées, faites travailler les outils et l'IA à partir de données centralisées et à jour.
- Écrivez une règle d'une page. Quelles données peuvent être utilisées avec l'IA, lesquelles jamais, et à qui demander en cas de doute. Une page lue vaut mieux qu'une charte de vingt pages que personne n'ouvre.
Comment Kyklos aborde le problème
Chez Kyklos, nous partons de ce constat : le choix du modèle d'IA compte moins que la maîtrise des données qu'on lui confie.
Chaque équipe importe ses données dans Kyklos : le CRM pour le commercial, la comptabilité et la banque pour la finance, le SIRH pour les ressources humaines. Kyklos crée ensuite des datasets, c'est-à-dire des jeux de données préparés pour un usage précis :
- filtrer : ne garder que les affaires au stade « contrat envoyé », par exemple ;
- séparer : un dataset par type de données, chacun partagé indépendamment. Les factures fournisseurs peuvent rester visibles par la seule direction financière ;
- anonymiser : retirer noms, prénoms et postes pour obtenir, par exemple, un dataset « rémunération × genre » que le CSE peut consulter sans qu'aucun salarié soit identifiable.
Chaque personne, et l'IA qu'elle utilise, ne voit que le dataset qui lui a été attribué. Seul ce qui est utile est partagé. Grâce au serveur MCP de Kyklos, vos équipes peuvent interroger ces datasets en langage naturel depuis un assistant d'IA compatible, sans jamais avoir à exporter un fichier complet vers un outil inconnu.
En résumé
- Le risque vient surtout de l'accès non maîtrisé aux données : des milliers d'applications métier sont aujourd'hui ouvertes à tous, souvent à cause d'un simple réglage par défaut.
- La responsabilité reste celle de l'entreprise, même quand un salarié a créé l'outil seul.
- Interdire fonctionne mal ; préparer les données fonctionne mieux : ne donner à chaque outil et à chaque IA que ce dont ils ont besoin.
Vous voulez savoir quelles données vos équipes pourraient confier à l'IA sans risque ? Réservez une démonstration de 30 minutes : nous regardons ensemble vos sources de données et nous vous montrons comment créer un premier dataset filtré ou anonymisé.
Sources
- LeMagIT, « "Vibe coding" : une menace que les DSI ne peuvent ignorer », Sean Michael Kerner, 3 juin 2026 : lien
- Étude Red Access sur 380 000 applications vibe codées, mai 2026 : synthèse Vibe Graveyard
- Matt Palmer, CVE-2025-48757 (Lovable) : lien ; analyse Superblocks
- Veracode, GenAI Code Security Report, juillet 2025 et mise à jour mars 2026 : communiqué ; rapport
- Paquets inventés par les IA (USENIX Security 2025) : synthèse Arnica
- CNIL, notifier une violation de données personnelles : lien
- Mécanique produit Kyklos (datasets, filtrer / séparer / anonymiser) : kyklos-ds.com